AI Well-Aging Company
AI
ビジョン・サウンド・テキストを統合した
ディープテック マルチモーダルAI
単一のAIモデルだけでは、ウェルエイジングに必要なヘルスケアサービス全般を実現できません。COMPLEXION は、SCI級論文と公認試験成績書で検証された自社開発AIモデルを基盤に、ウェルエイジングに特化した圧倒的なマルチモーダルコンテンツを提供します。
COMPLEXION x Multimodal AI
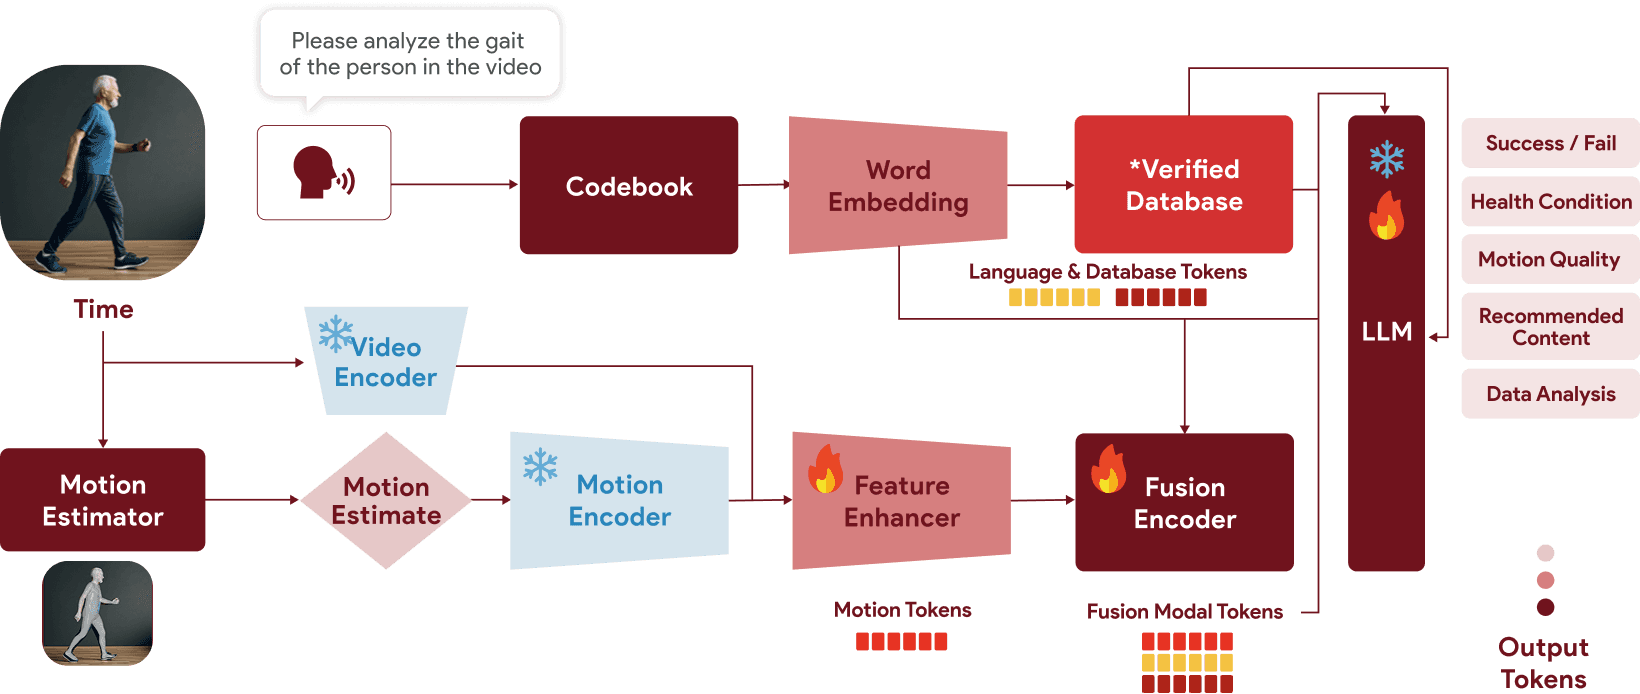
VISION
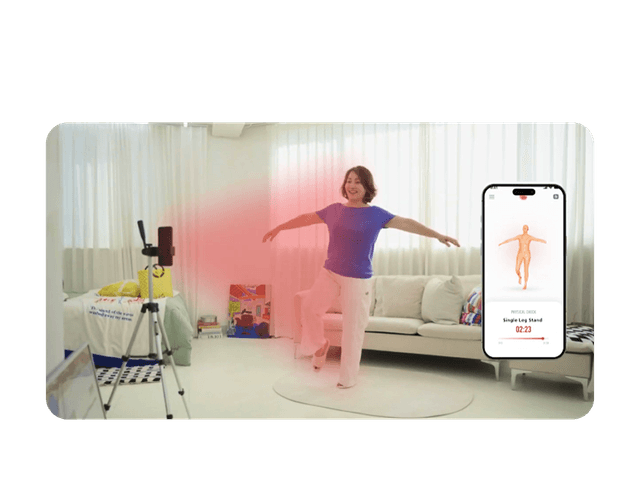
コンピュータビジョンAIでユーザーの行動パターンと姿勢を分析します
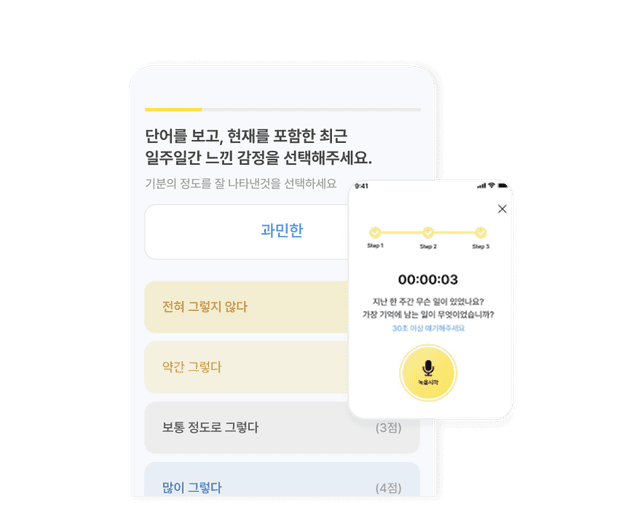
SOUND
ユーザーの音声特性をAIで分析し、症状を把握・分類します
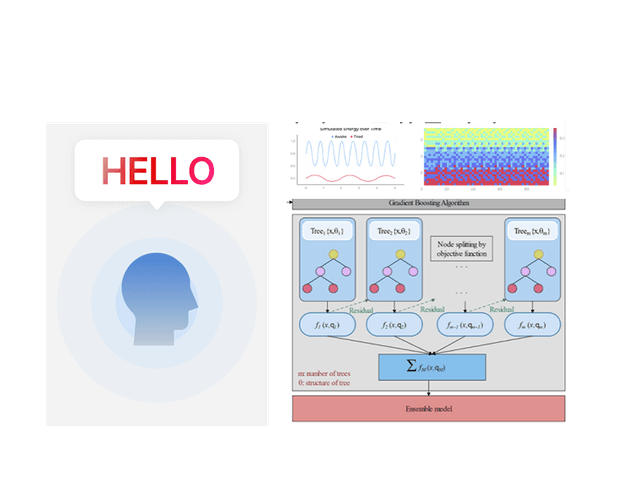
TEXT
パッシブデータと対話データを TEXT に変換し、健康要素を標準化します
COMPLEXION's Multimodal AI
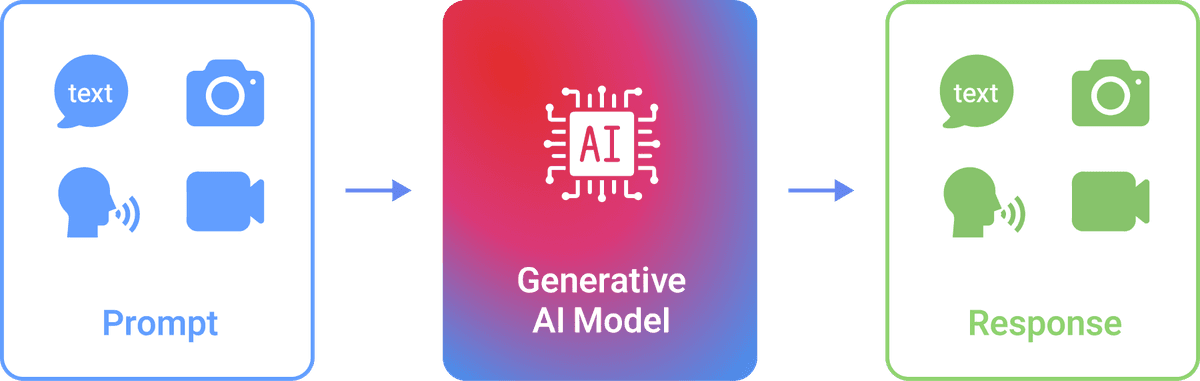
COMPLEXION のマルチモーダルAIモデルは Vision(映像)・Sound(音声)・Text(LLM)を統合的に分析し、
ユーザー一人ひとりの状態と目的に正確に合わせたフィードバックを生成します。
特に、従来のシングルモーダルAIと比べて2.79倍高いユーザー選好度が検証されています。
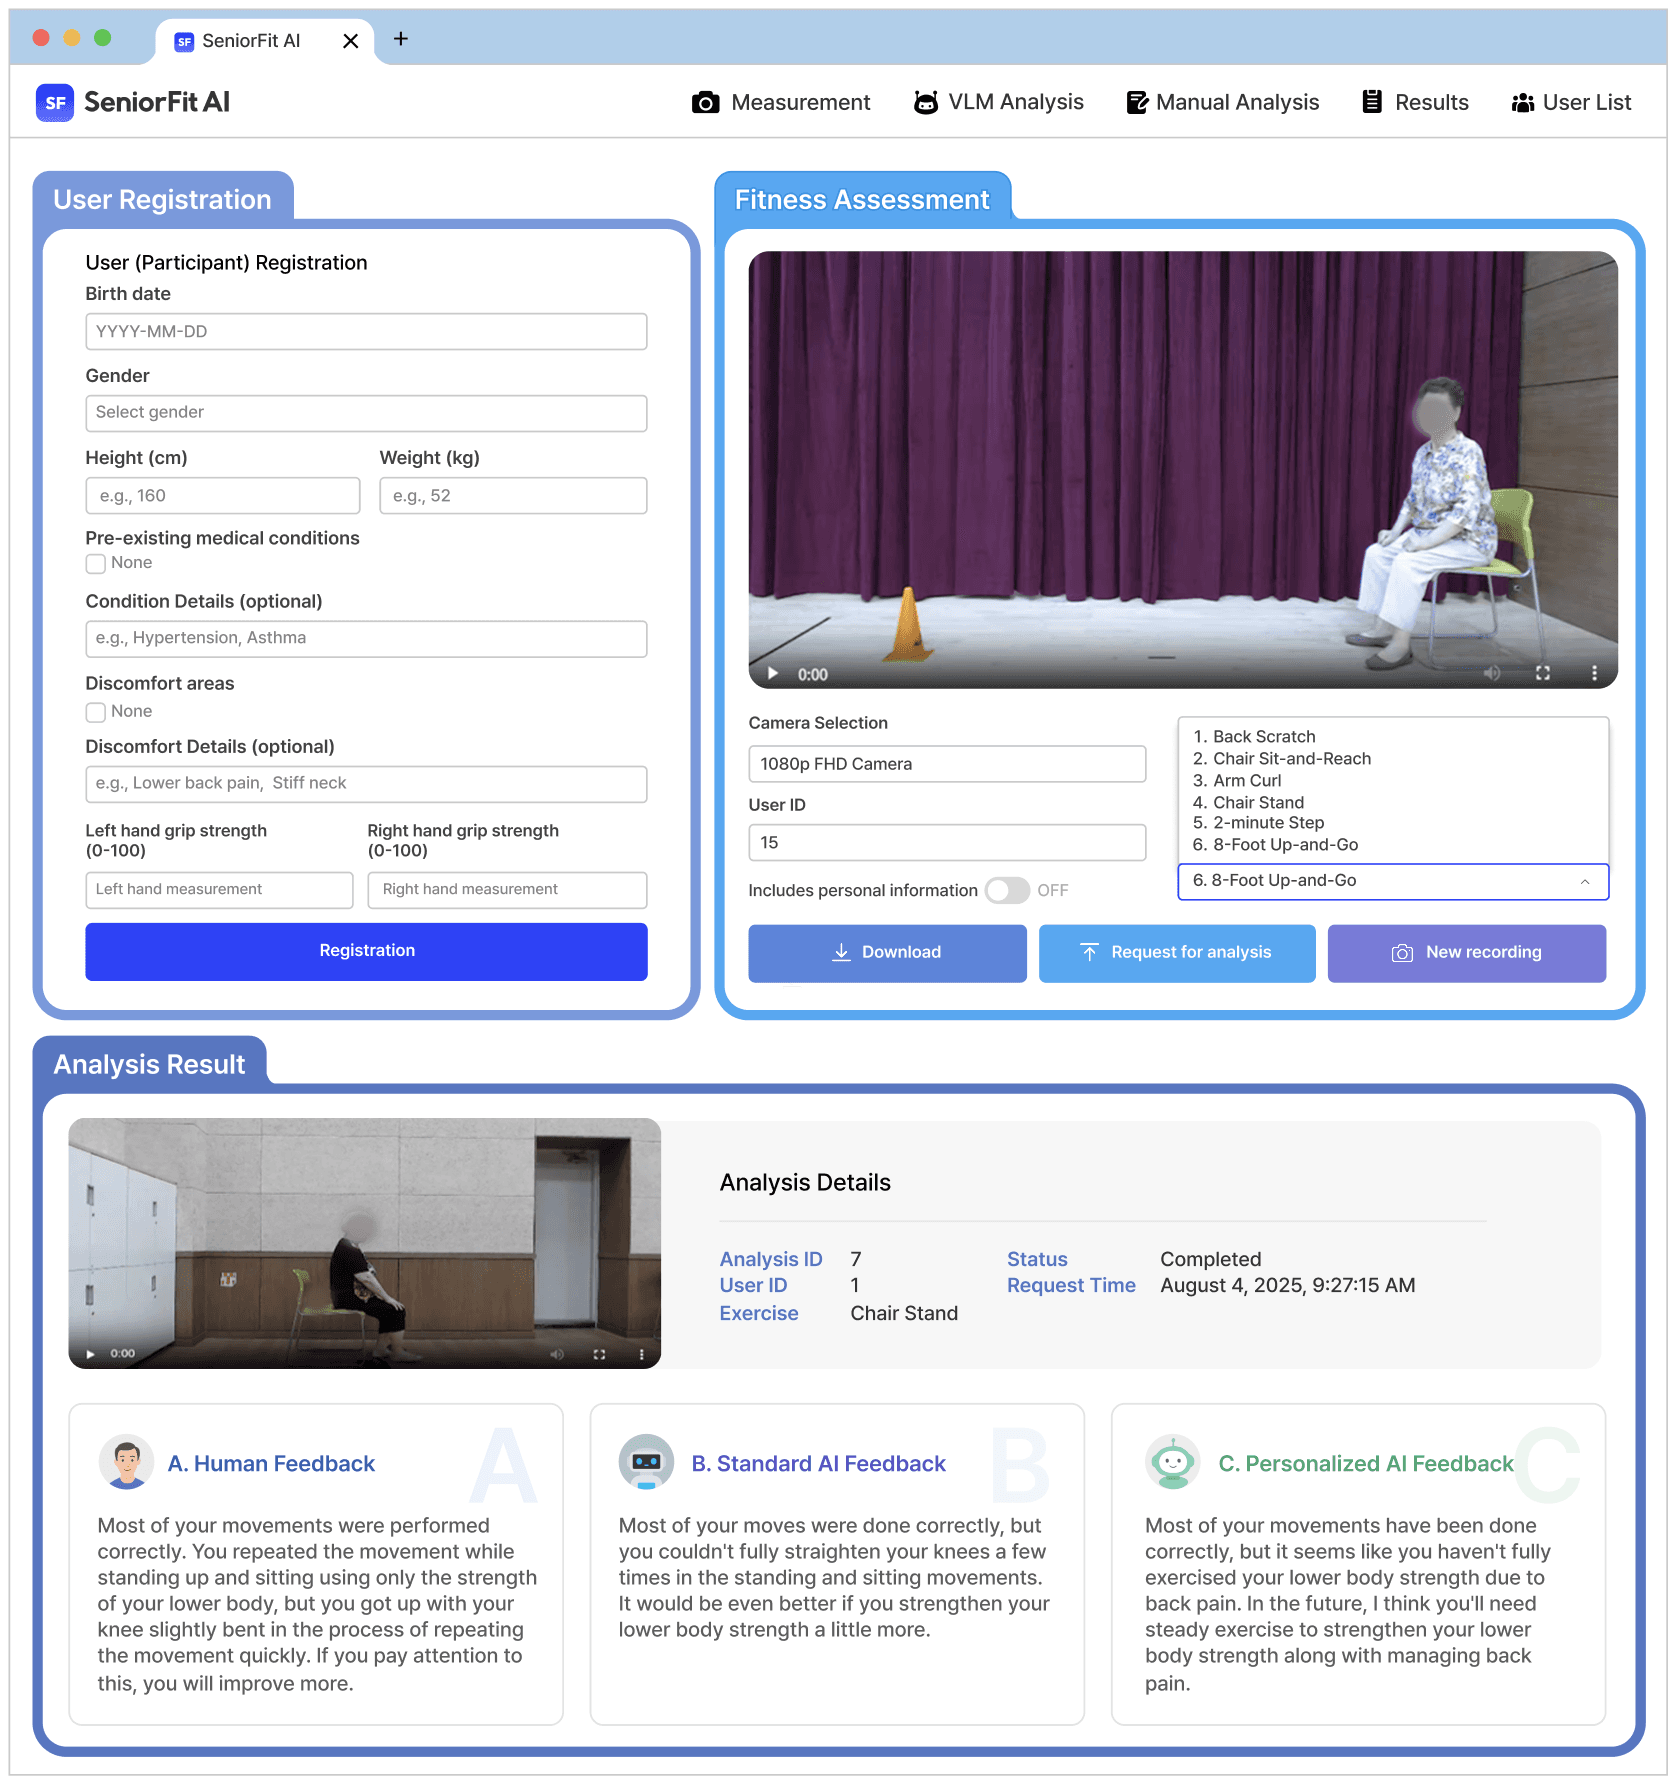
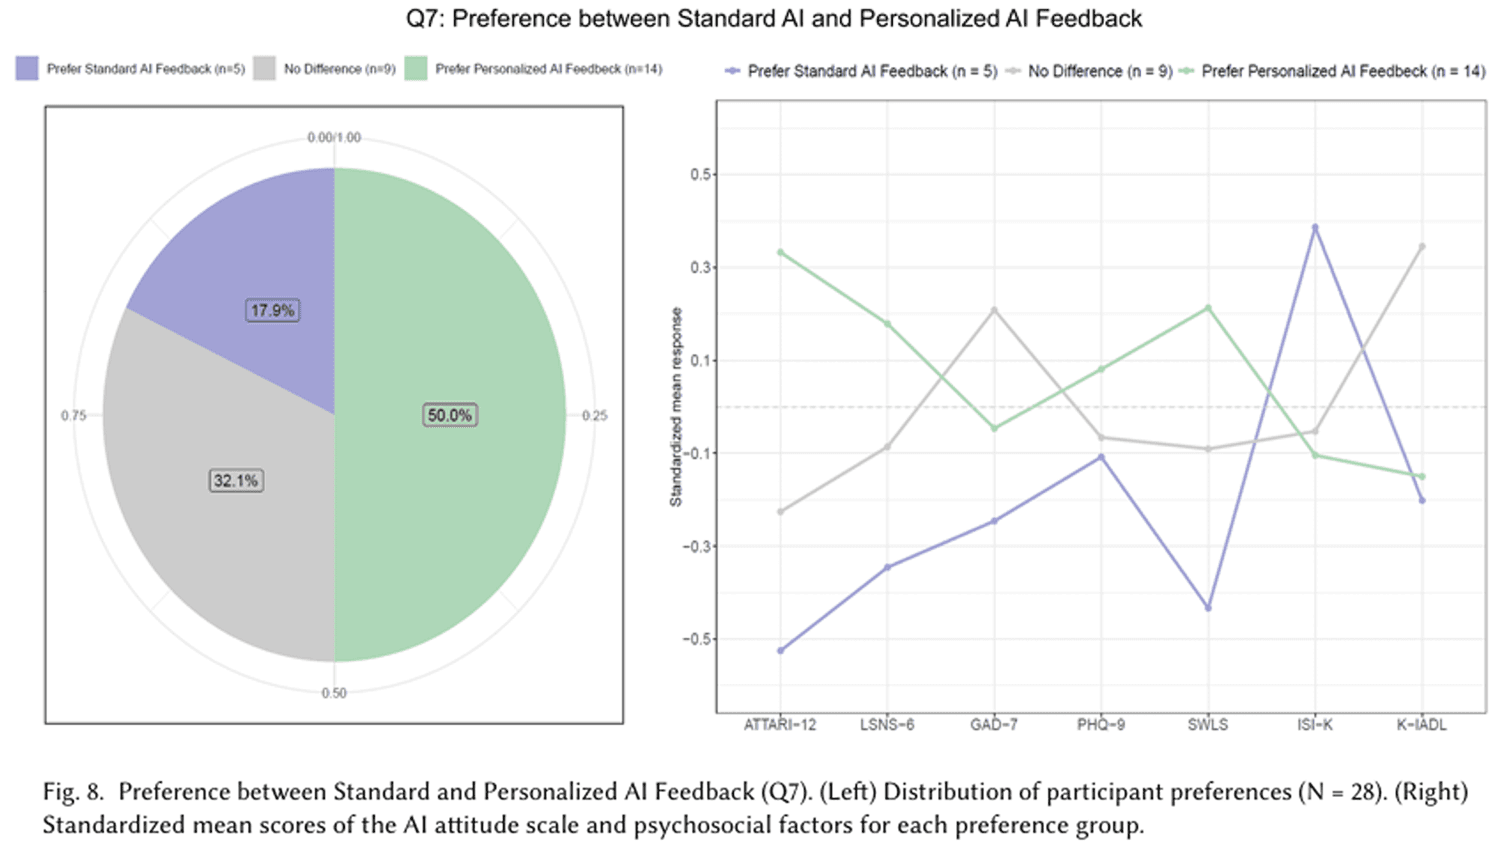
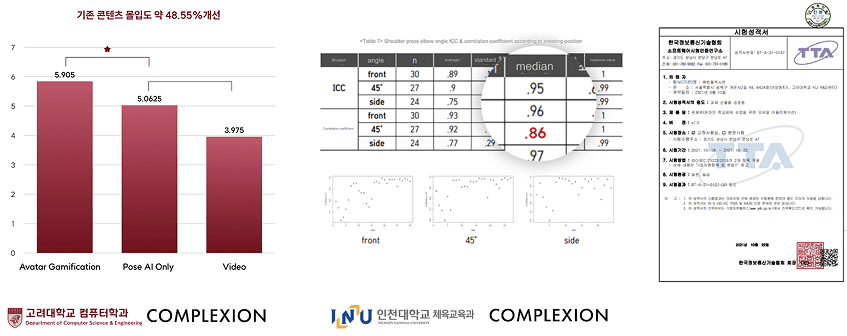
産学共同研究で 検証されたユーザー体験と機能性
COMPLEXION のAI技術は、機能的な精度だけでなくユーザー体験(UX)の完成度を高めるため、 計8回以上の公式な産学共同研究を通じて検証を完了しました。
SCI級 論文発表 1
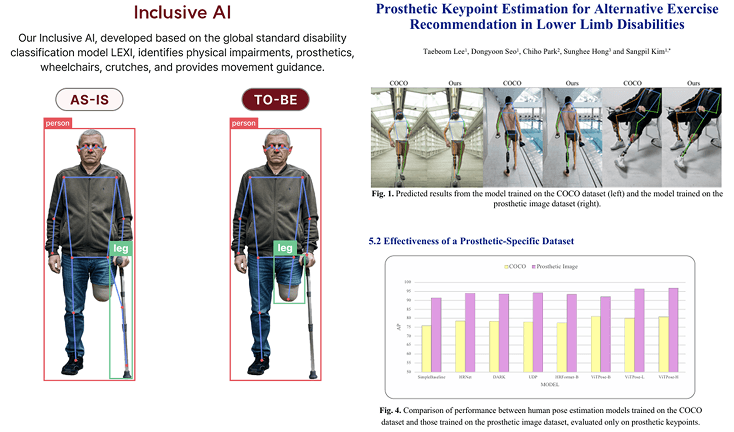
生成AIベースの手法により、従来の 障がい者の身体欠損認識率を約70%から 90%へ、計20%p向上させました。
SCI級 論文発表 2
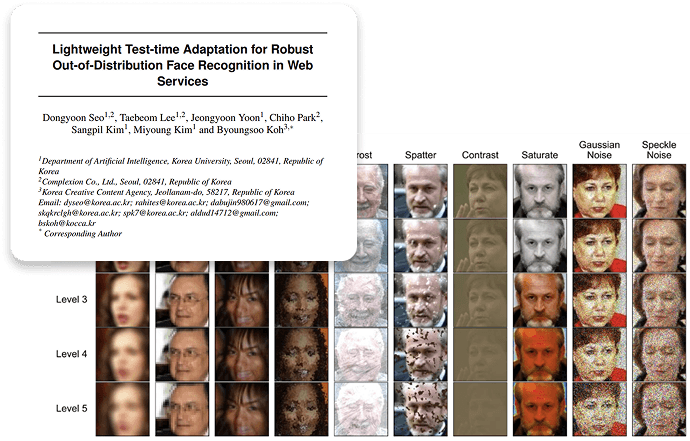
人の顔がほとんど識別できないほど ぼやけたり崩れたり、ノイズが激しく 混じった最悪の環境でも顔認識精度を 最大 +22.97%p 向上(従来比96.2%の 精度)させました。